Dies ist ein grundlegender Guide zum Verständnis der Grundlagen der Funktionsweise von KI-Modellen. Er legt den Grundstein für tiefergehende Konzepte, die in diesem Guide erläutert werden.
Was ist ein Token? Ein Token ist ein Textstück (ungefähr ein Wort oder
Wortfragment), das das Modell verarbeitet. Im Durchschnitt entspricht 1 Token
etwa 4 Zeichen. Zum Beispiel ist “Hallo Welt” 2 Tokens, während “Verständnis”
möglicherweise in 2 Tokens aufgeteilt wird: “Ver” und “ständnis”.
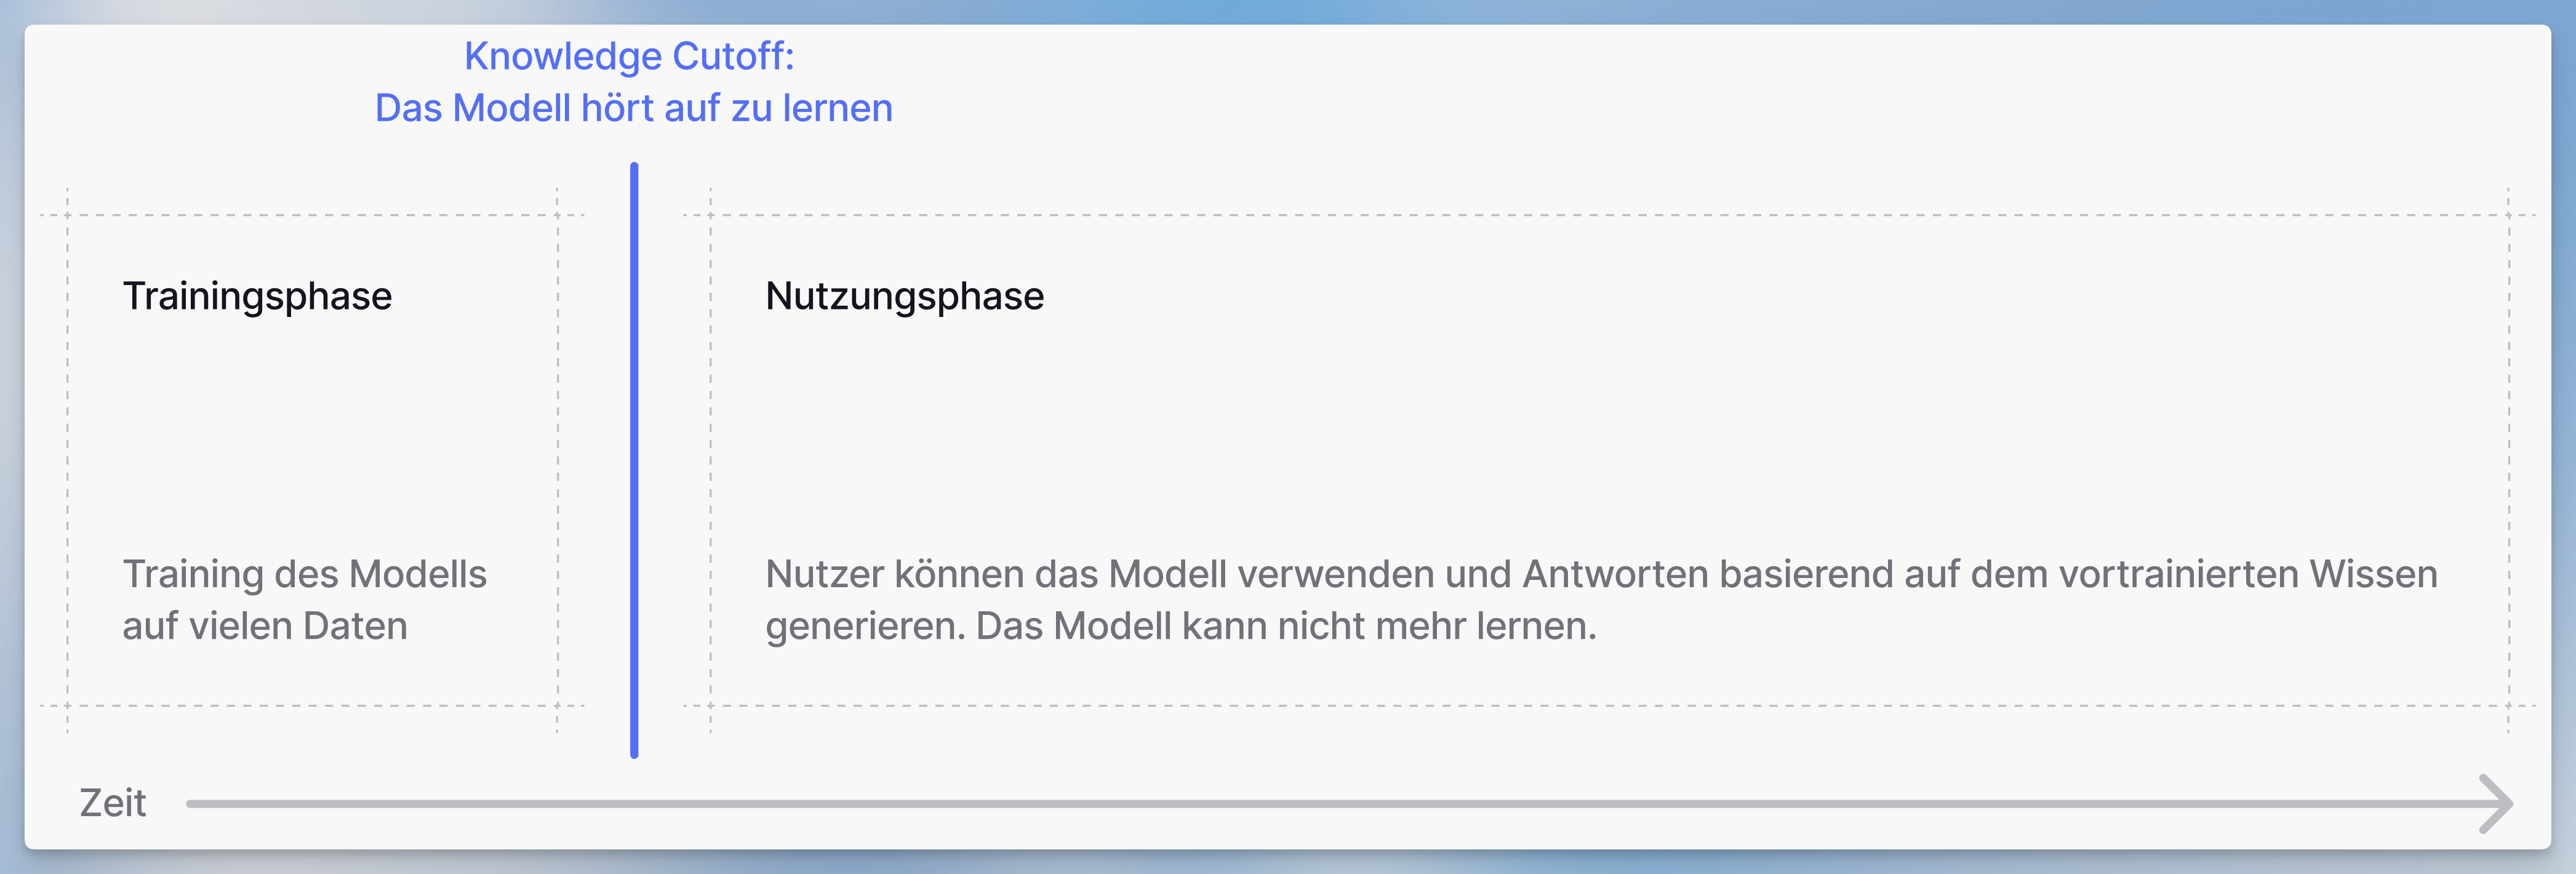
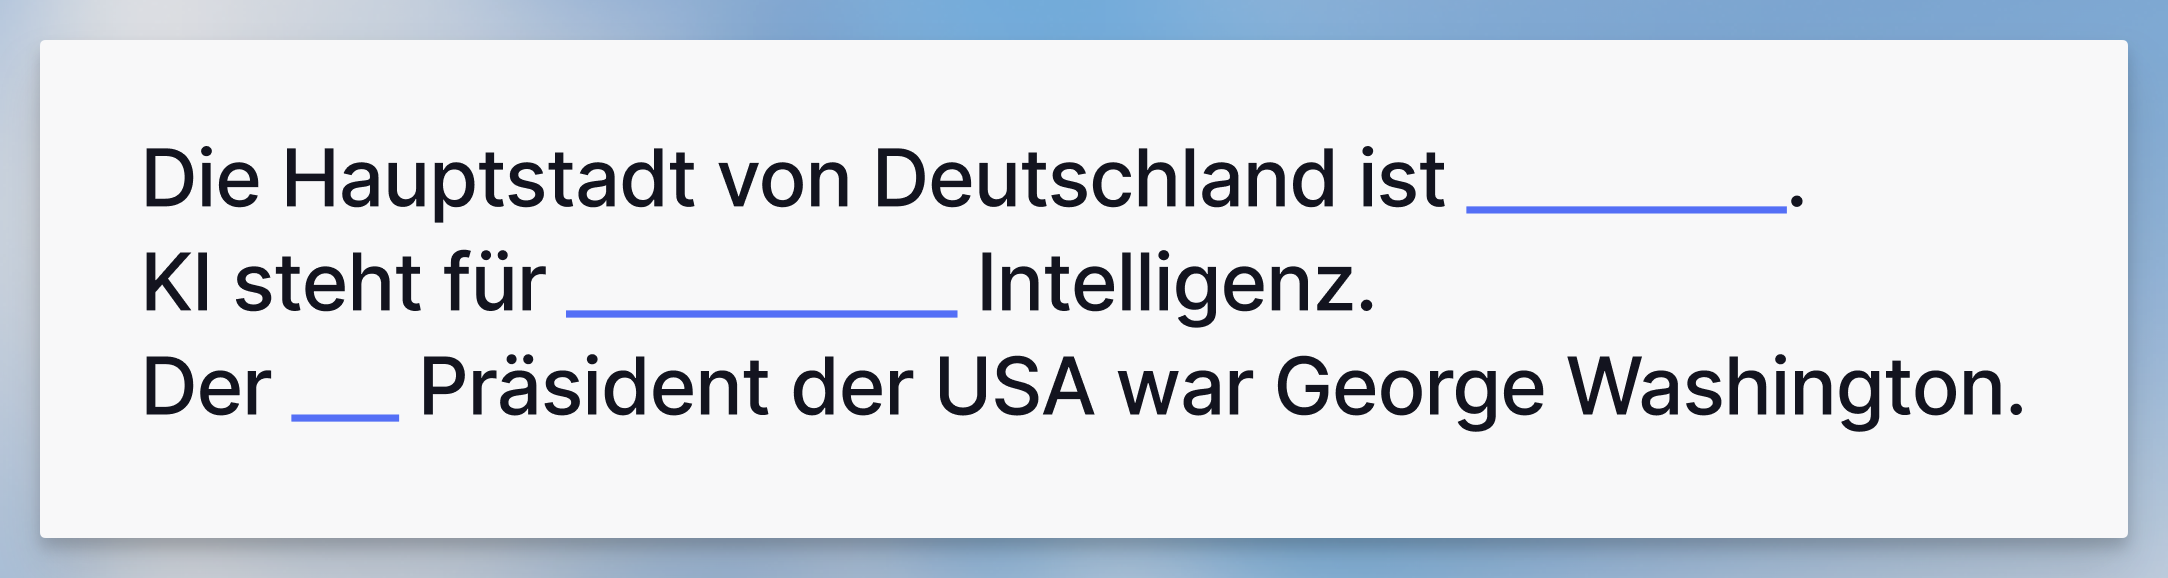
Während des Trainings verarbeitet das Modell große Mengen an Textdaten mit einer Technik namens “Next Token Prediction”. Das Modell lernt statistische Beziehungen zwischen Wörtern und Konzepten, indem es wiederholt vorhersagt, welches Wort als nächstes in einer Sequenz kommen sollte.Zum Beispiel wird es getestet, um Lücken in einem Text zu füllen. Damit lernt es Wahrscheinlichkeiten von Wörtern in verschiedenen Situationen (mehr dazu unten).Nachdem das Modell vollständig trainiert ist, kann es nicht mehr lernen. Das Datum, an dem das Training des Modells beendet wird, wird als “Knowledge Cutoff Date” bezeichnet, da das Modell nur Fakten bis zu diesem Datum gelernt hat und nichts weiß, was danach passiert.Schauen wir uns nun an, wie diese trainierten Modelle tatsächlich Antworten generieren.
Was ist Inferenz? Inferenz ist die Phase, in der ein trainiertes KI-Modell
Antworten auf deine Prompts generiert. Im Gegensatz zum Training (wenn das
Modell lernt) nutzt das Modell während der Inferenz sein bestehendes Wissen,
um Text vorherzusagen und zu generieren. Das Modell kann während dieser Phase
keine neuen Informationen lernen.
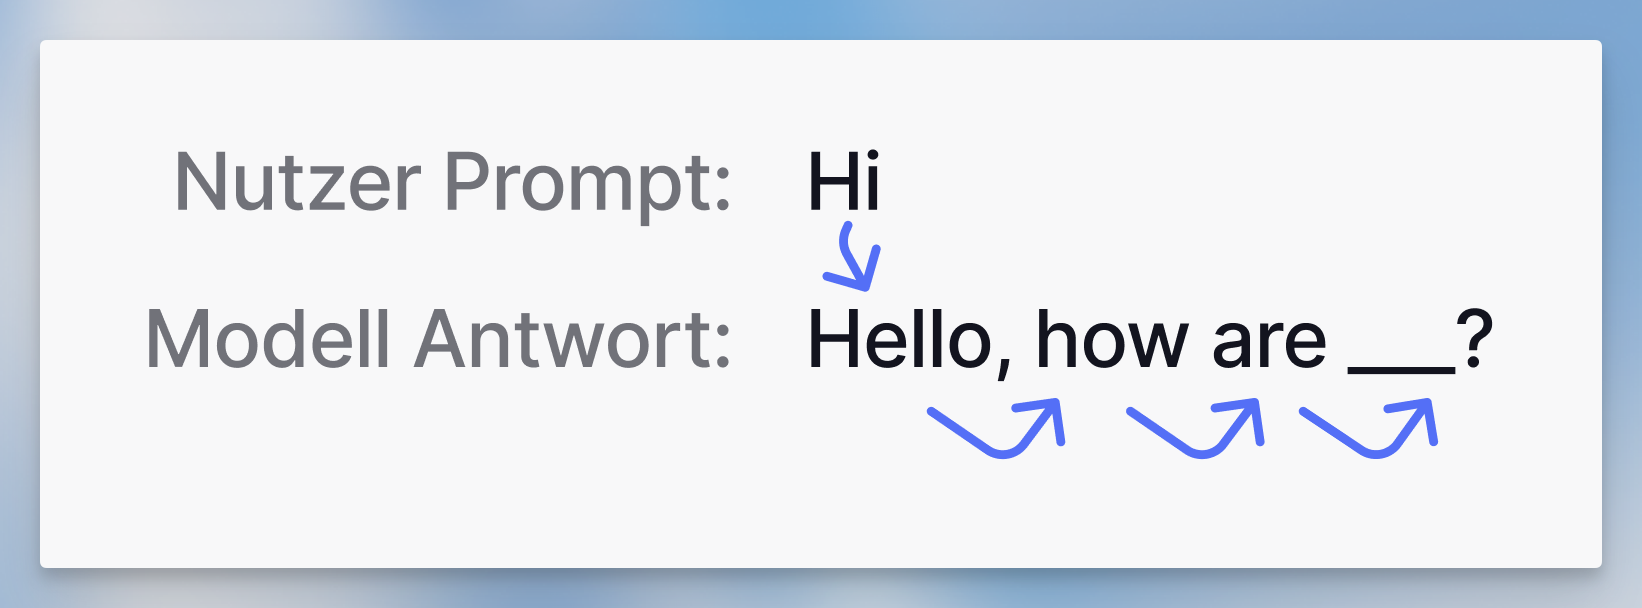
Während der Nutzungsphase (auch als Inferenz bekannt) generiert das Modell Antworten, indem es aus den Wahrscheinlichkeitsverteilungen sampelt, die es während des Trainings gelernt hat. Wenn du nach Künstlicher Intelligenz fragst, weist das Modell verwandten Begriffen wie Machine Learning eine viel höhere Wahrscheinlichkeit zu als unverwandten Begriffen wie Bananenkuchen.Wenn ein Nutzer eine Anfrage an das Modell sendet, wählt das Modell das nächste Wort oder Wortteil (Token) basierend auf diesen Wahrscheinlichkeiten aus.
Zum Beispiel lässt das Wort Hi vom Nutzer das Modell wahrscheinlich mit einem Gruß antworten. Es antwortet mit Hallo.
Dann generiert es das nächste wahrscheinlichste Wort basierend auf Hi und Hallo. Dieser Prozess wird wiederholt, bis das Modell entscheidet, dass die Anfrage ausreichend beantwortet wurde.
Was ist ein Context Window? Das Context Window (Kontextfenster) ist die
maximale Textmenge (gemessen in Tokens), die ein KI-Modell in einer einzelnen
Anfrage verarbeiten kann. Denke daran als “Arbeitsspeicher” des Modells.
Alles, was das Modell berücksichtigen soll, einschließlich deiner aktuellen Nachricht,
des Chat-Verlaufs, angehängter Dokumente und deiner Anweisungen, muss in dieses Limit passen.
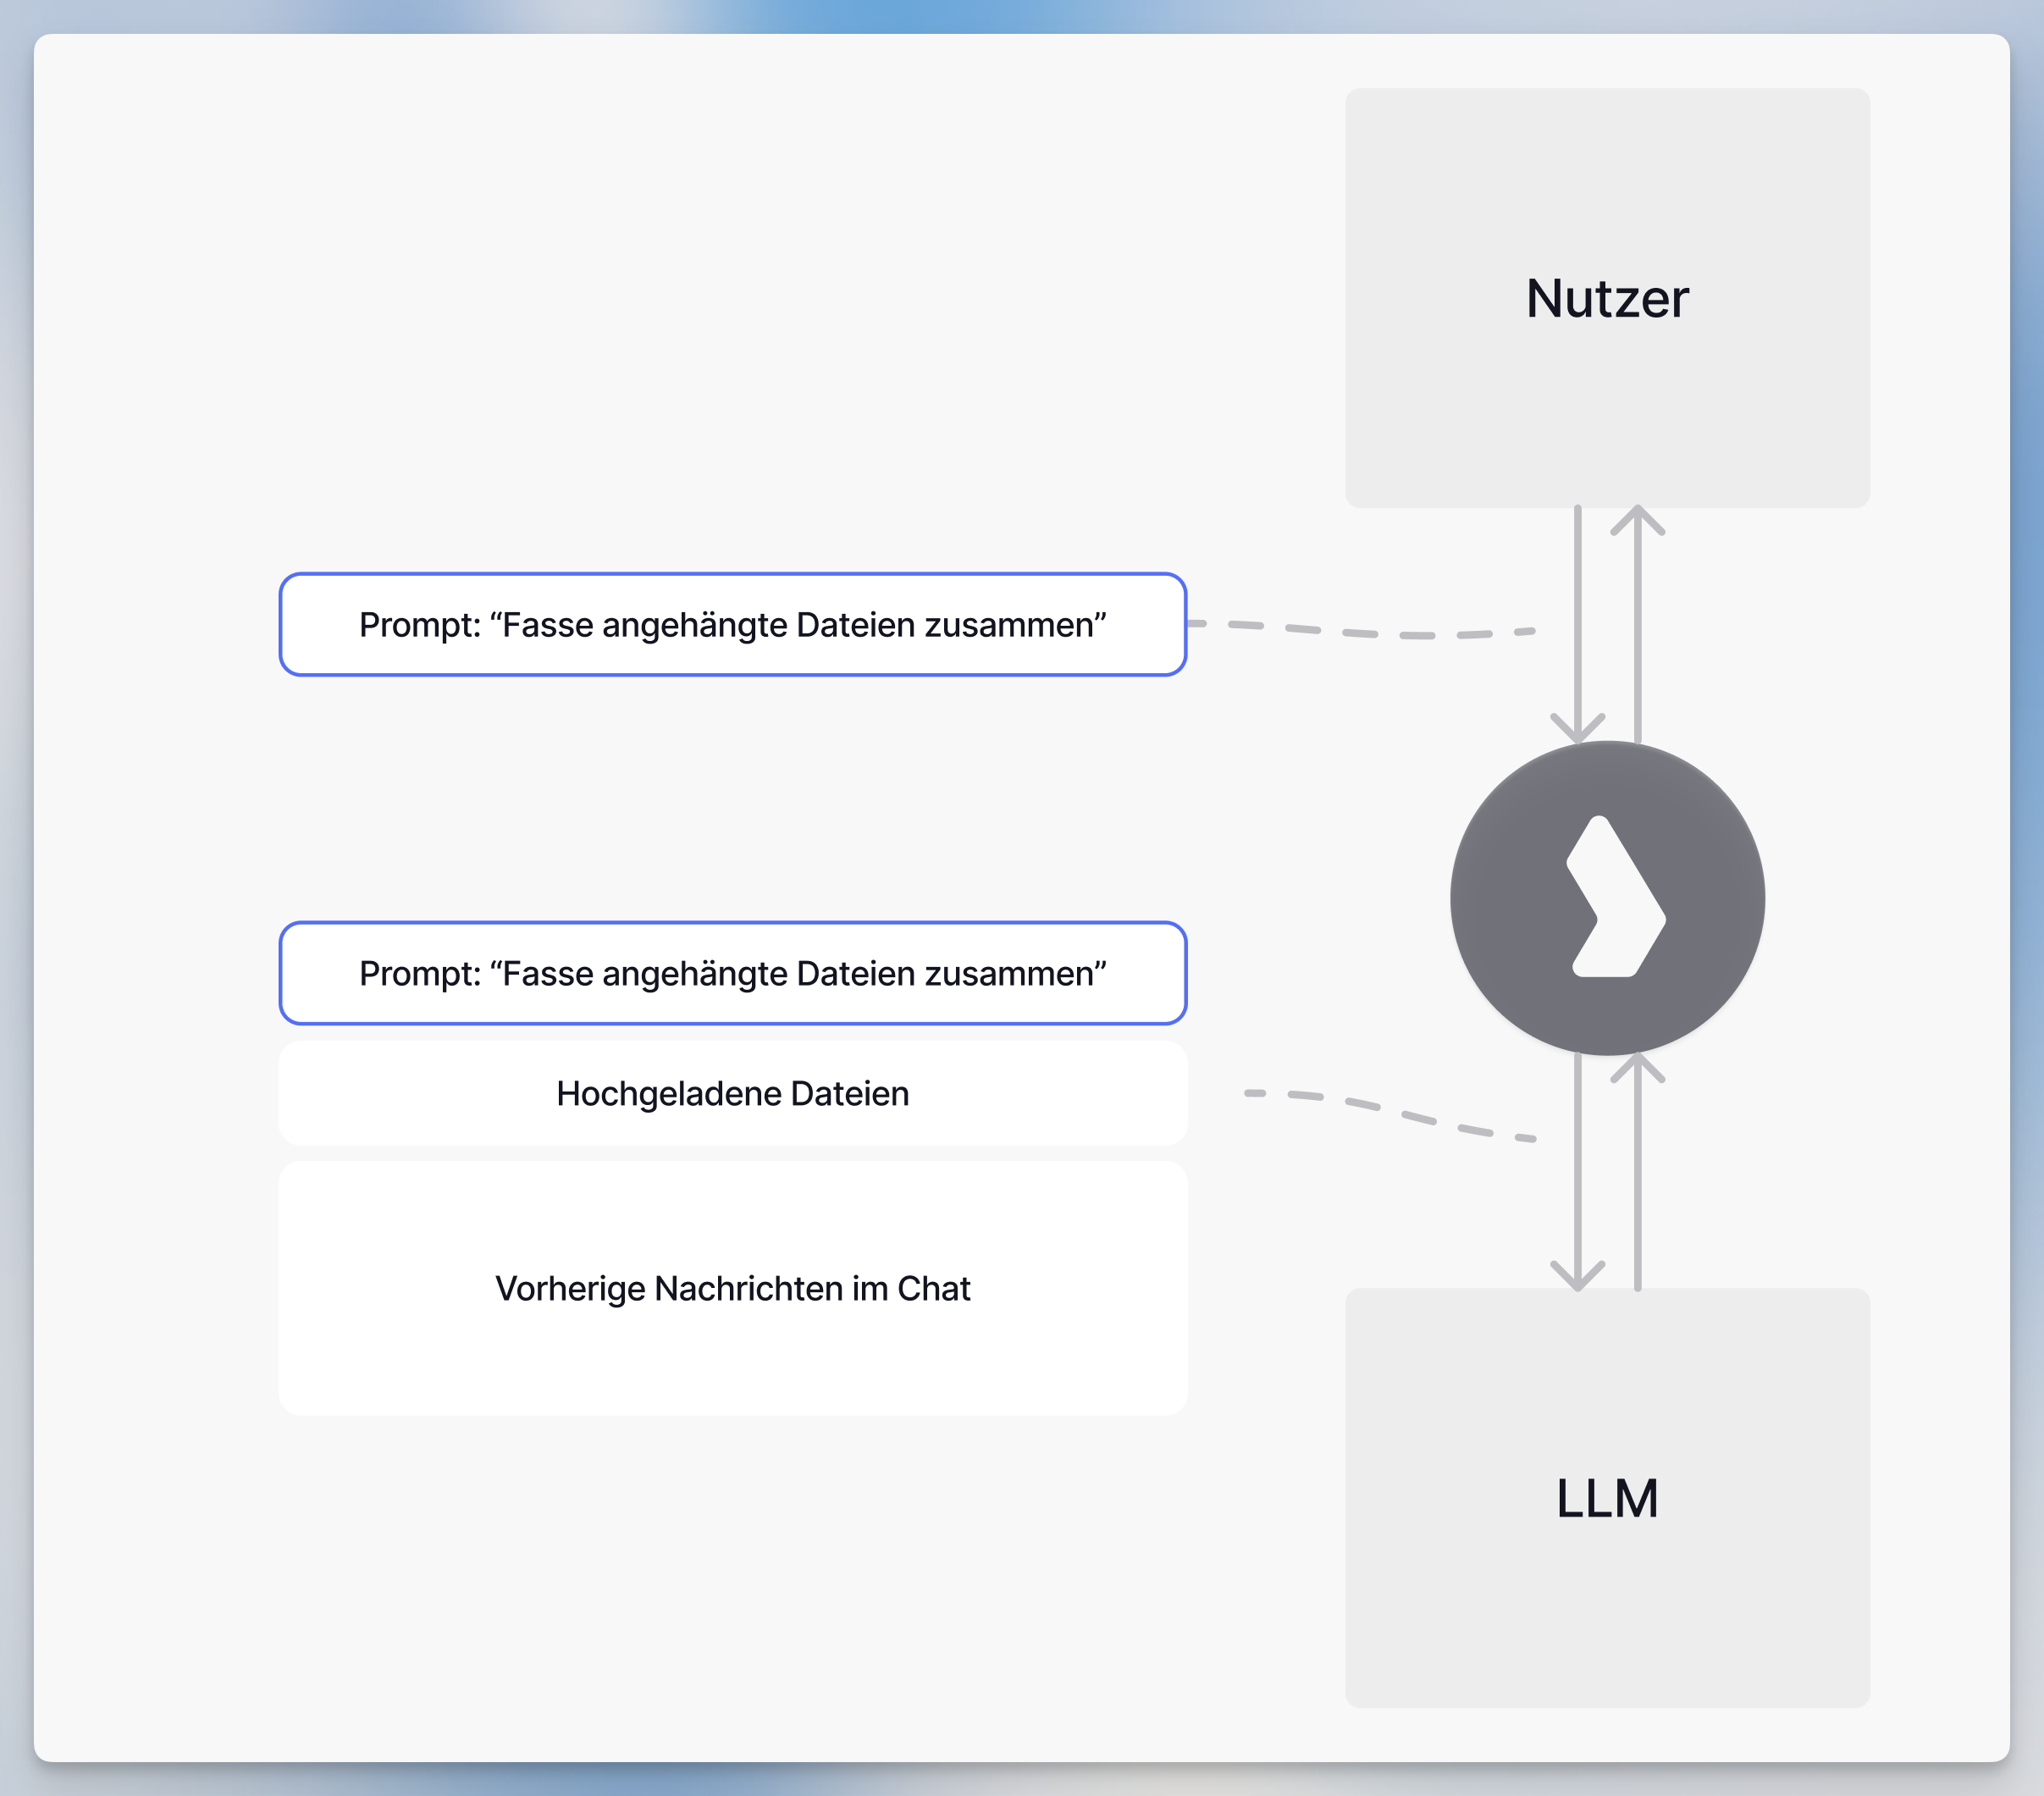
Wie bereits erwähnt, können die Modelle nach der Bereitstellung und nach Abschluss des Trainings nicht mehr lernen. Wie erinnern sie sich an vorherige Nachrichten oder integrieren neue Informationen? Die Antwort liegt im Context Window.Jede Anfrage an das Modell enthält den Kontext, der für diese spezifische Antwort benötigt wird: deine aktuelle Nachricht, den Chatverlauf, Inhalte aus angehängten Dokumenten, Systemanweisungen und Inhalte, die aus relevanten Wissensdatenbanken abgerufen wurden. Alle Inhalte müssen in das Context Window des Modells passen. Langdock kann lange Konversationen und große Dokumente kürzen oder zusammenfassen, bevor das Modell sie erhält.Das Modell behandelt jede Anfrage als völlig unabhängig, aber durch die Einbeziehung des gesamten relevanten Kontexts kann es kohärente Gespräche führen und auf vorherige Informationen verweisen.
War diese Seite hilfreich?
Assistant
Responses are generated using AI and may contain mistakes.